交通事故100万件を地図にする:やってみて初めて分かった6つの落とし穴
このドメインの3つ目のツール、交通事故ヒートマップを公開しました。データは政府のオープンデータで、落として使うだけに見えます。実際にやってみて間違えた6か所の記録です。
2026-08-20 作者 William Hsu
データの中身
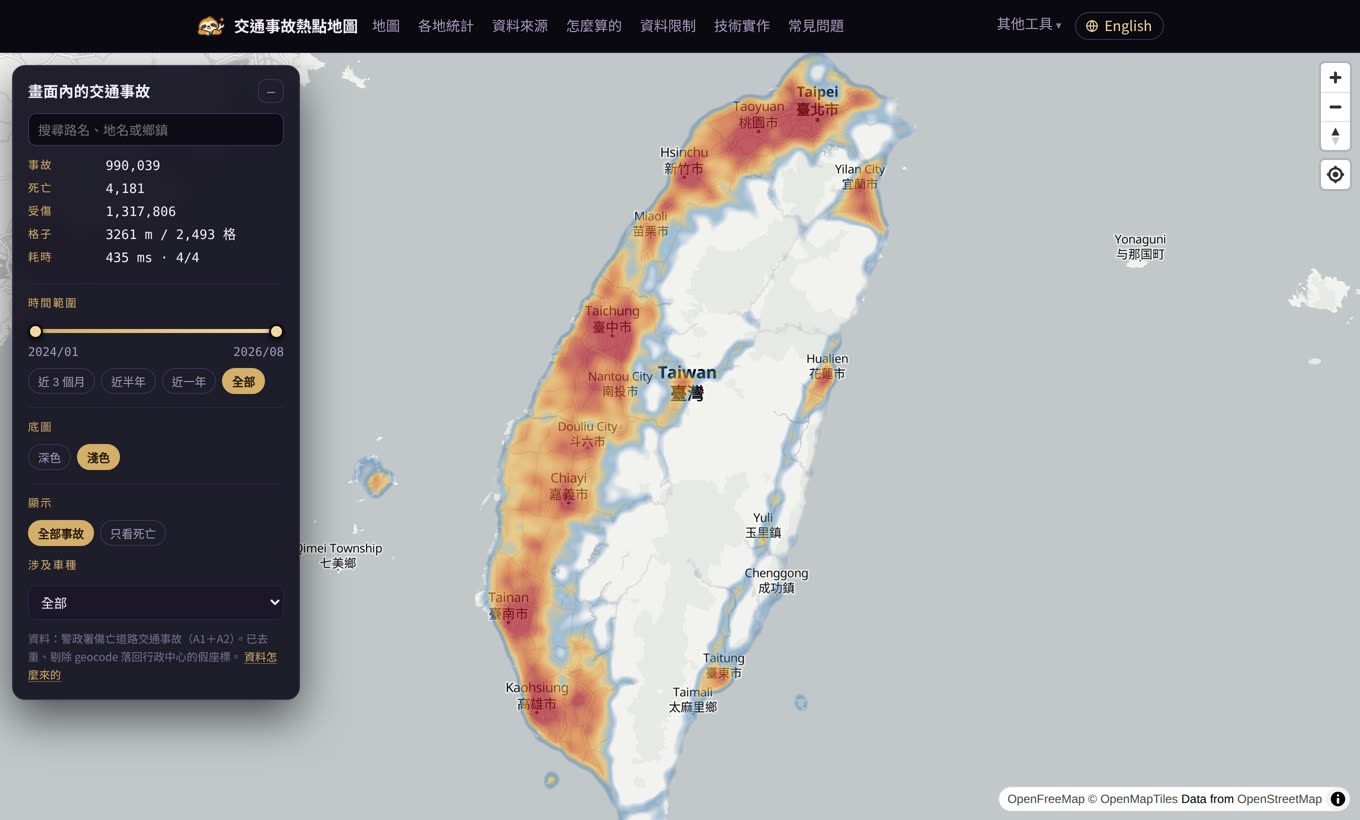
台湾の内政部警政署は政府オープンデータ基盤に、死傷道路交通事故を1件ずつ公開しています。A1類は24時間以内の死亡、 A2類は負傷または24時間を超えてからの死亡です。2024年と2025年の通年に、2026年8月までの更新分を足して使いました。
- 元の行数 2,287,215
- 列 51(緯度経度、天候、明るさ、制限速度、信号、原因判定、当事者の年齢と保護具など)
- 期間 2024年1月〜2026年8月、32か月
ダウンロードはzipで、3年分を展開すると1.5GB。ディスクが足りないので、処理全体をzipから直接読む方式にして、 一度もディスクに落とさないようにしました。
一、1行は1件の事故ではなく1人の当事者
事故1件につき、当事者の数だけ行があります。車がバイクにぶつかれば2行で、時刻も場所も緯度経度も同じ、 違うのは当事者の順位だけです。
228万行を重複除去すると101万件、1件あたり平均2.26人。行数をそのまま数えると、どの数字も2倍以上に膨らみます。
二、台湾最大の事故ホットスポットは新北市役所の玄関先
最初にデータを描いたとき、いちばん明るい点は新北市板橋の121.481, 25.009にありました。 そこに年間2千件以上が積み上がっています。
それは新北市政府の座標です。ジオコーディングが失敗すると既定値に戻され、その既定値がその県市の役所の位置なのです。 その点に乗っている事故の住所を調べると、三峽・八里・坪林など20の行政区にまたがっていました。
見つけ方は簡単です。同じ座標の事故住所が3つ以上の行政区にまたがっていれば、その点は偽物。 本物の交差点が三峽と八里に同時に存在することはありません。全国で128か所、17,784件、全体の1.76%が該当しました。
割合は高くありませんが、1点に集中するのでヒートマップ上ではいちばん大きな塊になります。 放置すると、地図でいちばん目立つ情報が間違いということになります。
三、このデータで「最も危険な交差点」は決められない
これはプログラムの話ではなく、データそのものの性質です。
台中市は事故件数が全国最多で年間70,765件。ところが全国のホットスポット上位200件を並べると、 新北市が121件を占め、台中市は19件しかありません。
理由は県市ごとにジオコーディングの挙動が違うからです。同じ座標が使い回される比率は、新北市が1.38、台北市は1.01。 台北市はほぼすべての事故に固有の座標があるので、そもそも「ホットスポット」が形になりません。
このデータで作った危険な交差点ランキングは、危険度ではなく各県市のジオコーディングの癖を並べているだけです。 だからこのツールにはあえてランキングを置かず、範囲統計だけにしています。 300〜500メートルの範囲なら、数十メートルの座標誤差はならされます。
さらに26.2%の住所が「○○路の前0.0メートル」と書かれています。これは道路区間の参照点で、事故が起きた地点ではありません。 街路レベルの判断には使えますが、交差点レベルの結論は出せません。
四、少し動かすたびに画面全体を取り直す
最初のAPIはbboxを受け取る方式でした。フロントが現在の地図範囲を送り、バックエンドがその範囲を返す。 動きはしますが、1ピクセル動かすだけで新しいbbox=新しいURLになるので全部取り直しになり、 しかもブラウザにもCDNにもキャッシュされません。実測で1回の応答が954KBでした。
地図を固定のタイルに切り、URLを /api/cells/{z}/{x}/{y} にしました。URLが固定ならキャッシュでき、 移動しても新しく現れた分だけ取りに行きます。
- 初回読み込み 12タイル、195KB
- 200ピクセル移動 新しい3タイルだけ、約10KB
- 戻る リクエスト0件、14ミリ秒
五、データベースをバインドマウントに置いたら74倍遅い
開発機では何ともないのに、本番に載せたら同じクエリが5.5秒かかりました。
本番のフォルダはWindowsホストからDockerコンテナにバインドマウントしています。SQLiteは小さなランダム読み出しを大量にするので、 そのアクセスパターンはバインドマウント上で目も当てられない遅さになります。同じクエリの3通り:
- 開発機のローカルディスク 74ミリ秒
- コンテナからバインドマウントを読む 5,500ミリ秒
- コンテナからローカル複製を読む 84ミリ秒
解決策は、起動時にデータベースをコンテナ自身のファイルシステムへ順次コピーしてから使うこと。 順次読み出しは速く、122MBでも数秒です。この問題は開発機ではまったく見えず、デプロイして初めて現れます。
六、色を2回間違えた。1回目は真っ赤、2回目は真っ青
ヒートマップの重みは相対値なので、事故件数を0〜1の重みにどう変換するかで地図全体の見え方が決まります。
1回目は真っ赤。APIをbboxからタイルに変えたときに重みの列を落としてしまい、フロントは未設定とみなして 1件のマスも300件のマスも重みを最大にしてしまいました。
2回目は真っ青。97パーセンタイルを満点にしたのですが、この分布は極端に偏っています。 全国表示では中央値が38件、最大のマスが15,601件で400倍の差。97パーセンタイルを分母にすると、 97%のマスの重みがほぼ0になります。
最終的に最大値に対する対数を取る方式にしました。中央値のマスが0.38、500件のマスが0.64、最大が1.0。 これでようやく中間の段階が広がります。
拡大すると点が規則的な格子に並ぶ
街路レベルまで拡大すると点の並びが不自然で、道路と合っていない、という指摘がありました。
マスの中心を描いていたからです。13メートルのマスの中心を描けば、街路レベルでは格子線が見えますし、 道路がすべてのマスの中心を通るはずもありません。
データベースを作り直し、各マスに含まれる事故の緯度経度の合計も保存して、 クエリ時にそのマスの実際の重心を返すようにしました。今は点が道路の上に乗り、道路網に沿って分布します。
振り返り
6つのうち技術的な問題は4番目と5番目だけで、残りは「データはきれいだろう」という思い込みから来ています。 政府のオープンデータは実のところ品質が良く、項目も細かく更新も熱心です。ただし行政のために設計されていて、 その用途は地図を描くことではありません。座標は後から補われたもので、補い方には独自の論理があり、 その論理は統計上は無害でも、地図の上では致命的になります。
次にオープンデータを手にしたら、描き始める前にまず、いちばん極端な値がどこから来たのかを見に行くつもりです。