교통사고 100만 건을 지도로: 해보고 나서야 알게 된 여섯 가지 함정
이 도메인의 세 번째 도구인 교통사고 히트맵을 공개했습니다. 데이터는 정부 공개 자료라 내려받아 쓰면 될 것처럼 보입니다. 실제로 만들면서 틀렸던 여섯 곳의 기록입니다.
2026-08-20 作者 William Hsu
데이터가 어떻게 생겼나
대만 경찰청은 정부 공개 데이터 플랫폼에 사상 도로교통사고를 건별로 올립니다. A1류는 24시간 이내 사망, A2류는 부상 또는 24시간 이후 사망입니다. 2024년과 2025년 전체에 2026년 8월까지의 갱신분을 더해 썼습니다.
- 원본 행 수 2,287,215
- 컬럼 51개(위경도, 날씨, 밝기, 제한속도, 신호, 원인 판정, 당사자 나이와 보호장구 등)
- 기간 2024년 1월~2026년 8월, 32개월
내려받으면 zip이고, 3년치를 풀면 1.5GB입니다. 디스크가 부족해서 파이프라인 전체를 zip에서 바로 읽도록 바꿔 한 번도 디스크에 쓰지 않습니다.
1. 한 행은 사고 한 건이 아니라 당사자 한 명
사고 한 건에는 당사자 수만큼 행이 있습니다. 차가 오토바이를 치면 두 행이고, 시간·장소·위경도가 모두 같으며 당사자 순번만 다릅니다.
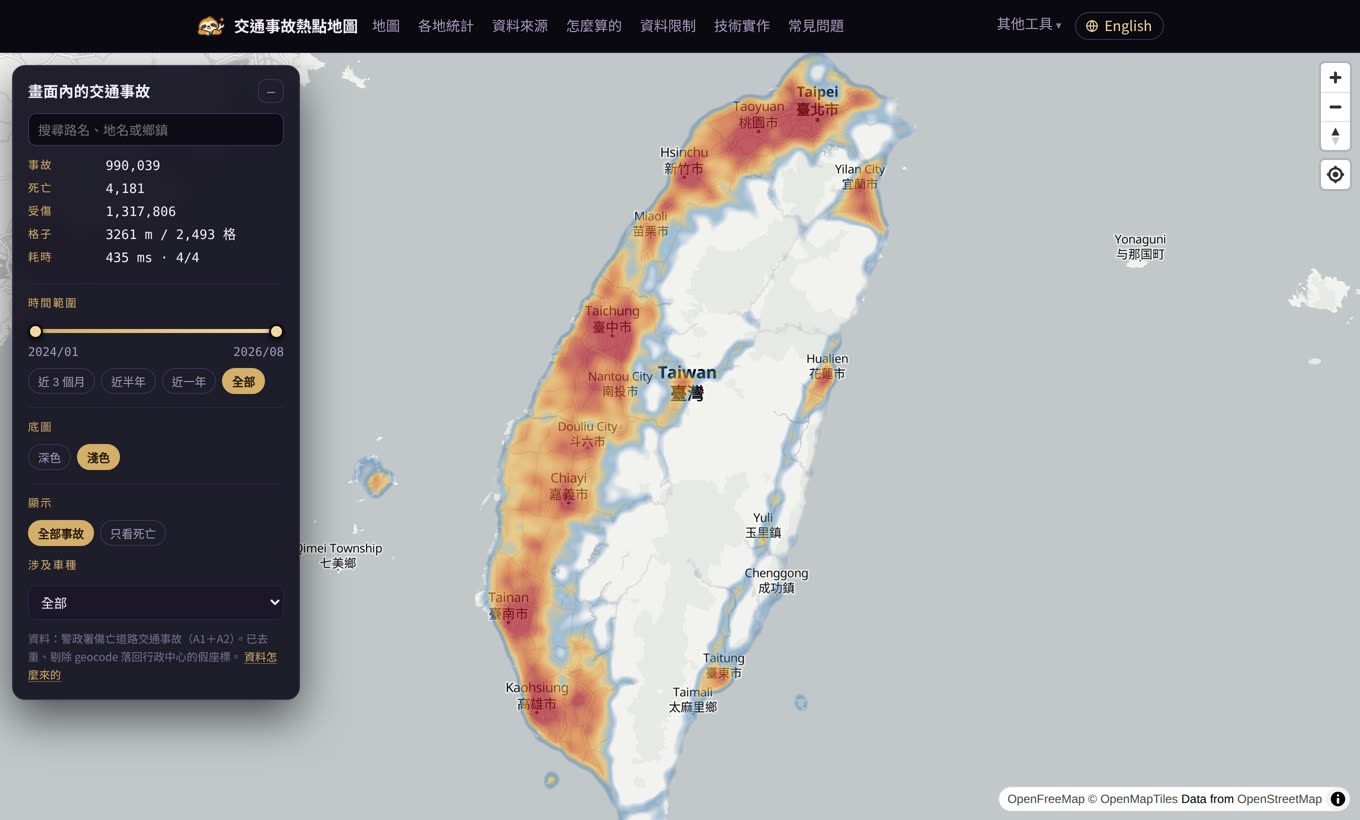
228만 행을 중복 제거하면 101만 건, 건당 평균 2.26명입니다. 행 수를 그대로 세면 모든 숫자가 두 배 넘게 부풀려집니다.
2. 대만 최대의 사고 핫스팟은 신베이시청 정문
데이터를 처음 그렸을 때 가장 밝은 점이 신베이 반차오의 121.481, 25.009에 있었습니다. 거기에 한 해 2천 건 넘게 쌓여 있었습니다.
그것은 신베이시 정부의 좌표입니다. 지오코딩이 실패하면 기본값으로 되돌아가는데, 그 기본값이 해당 시·현 청사의 위치입니다. 그 점에 얹힌 사고 주소를 보니 싼샤, 바리, 핑린 등 20개 행정구에 걸쳐 있었습니다.
찾는 방법은 간단합니다. 같은 좌표의 사고 주소가 세 개 이상의 행정구에 걸치면 가짜 점입니다. 진짜 교차로가 싼샤와 바리에 동시에 있을 수는 없으니까요. 전국에서 128곳, 17,784건, 전체의 1.76%가 걸렸습니다.
비율은 높지 않지만 한 점에 몰리기 때문에 히트맵에서는 가장 큰 덩어리가 됩니다. 그대로 두면 지도에서 가장 눈에 띄는 정보가 틀린 정보가 됩니다.
3. 이 데이터로 "가장 위험한 교차로"를 매길 수 없다
이건 프로그램 이야기가 아니라 데이터 자체의 성질입니다.
타이중시는 사고 건수가 전국 최다로 연 70,765건입니다. 그런데 전국 상위 200개 핫스팟을 뽑으면 신베이시가 121개를 차지하고 타이중시는 19개뿐입니다.
이유는 시·현마다 지오코딩 방식이 다르기 때문입니다. 같은 좌표가 재사용되는 비율이 신베이시는 1.38, 타이베이시는 1.01입니다. 타이베이시는 거의 모든 사고에 고유 좌표가 있어서 "핫스팟"이 아예 형성되지 않습니다.
이 데이터로 만든 위험한 교차로 순위는 위험도가 아니라 각 시·현의 지오코딩 습관을 줄 세운 것입니다. 그래서 이 도구에는 일부러 순위표를 두지 않고 범위 통계만 둡니다. 300~500미터 범위에서는 수십 미터의 좌표 오차가 상쇄됩니다.
게다가 주소의 26.2%가 "○○로 앞 0.0미터"로 적혀 있습니다. 그건 도로 구간의 기준점이지 사고 지점이 아닙니다. 거리 수준의 판단은 참고할 수 있어도 교차로 수준의 결론은 낼 수 없습니다.
4. 조금만 움직여도 화면 전체를 다시 받아옴
첫 API는 bbox를 받았습니다. 프런트가 현재 지도 범위를 보내면 백엔드가 그 범위를 돌려주는 방식입니다. 동작은 하지만 1픽셀만 움직여도 새 bbox, 즉 새 URL이 되어 전부 다시 받아오고, 브라우저도 CDN도 캐시할 수 없습니다. 실측으로 한 번 응답이 954KB였습니다.
지도를 고정 타일로 자르고 URL을 /api/cells/{z}/{x}/{y}로 바꿨습니다. URL이 고정이면 캐시되고, 이동할 때는 새로 드러난 타일만 받아옵니다.
- 첫 로딩 타일 12개, 195KB
- 200픽셀 이동 새 타일 3개만, 약 10KB
- 되돌아오기 요청 0건, 14밀리초
5. 데이터베이스를 바인드 마운트에 뒀더니 74배 느림
개발 기기에서는 멀쩡한데 정식 사이트에 올리니 같은 질의가 5.5초 걸렸습니다.
운영 환경의 폴더는 윈도우 호스트에서 도커 컨테이너로 bind mount한 것입니다. SQLite는 작은 무작위 읽기를 대량으로 하는데, 그 접근 패턴이 bind mount 위에서는 형편없이 느립니다. 같은 질의를 세 가지 경우로:
- 개발 기기 로컬 디스크 74밀리초
- 컨테이너에서 bind mount 읽기 5,500밀리초
- 컨테이너에서 로컬 복사본 읽기 84밀리초
해법은 시작할 때 데이터베이스를 컨테이너 자체 파일시스템으로 순차 복사한 뒤 쓰는 것입니다. 순차 읽기는 빨라서 122MB도 몇 초면 끝납니다. 이 문제는 개발 기기에서는 전혀 보이지 않고 배포한 뒤에야 드러납니다.
6. 색 설정을 두 번 잘못했다. 한 번은 온통 빨강, 한 번은 온통 파랑
히트맵의 가중치는 상대값이라, 사고 건수를 0~1 가중치로 어떻게 옮기느냐가 지도 전체의 인상을 결정합니다.
첫 번째는 온통 빨강이었습니다. API를 bbox에서 타일로 바꾸면서 가중치 컬럼을 빠뜨렸고, 프런트는 설정 안 된 것으로 보고 1건짜리 칸이든 300건짜리 칸이든 가중치를 최대로 줬습니다.
두 번째는 온통 파랑이었습니다. 97번째 백분위수를 만점으로 삼았는데, 이 분포는 극단적으로 치우쳐 있습니다. 전국 시야에서 중앙값이 38건, 가장 큰 칸이 15,601건으로 400배 차이입니다. 97번째 백분위수를 분모로 쓰면 칸의 97%가 거의 0이 됩니다.
최종적으로 최대값에 대해 로그를 취하는 방식으로 바꿨습니다. 중앙값 칸이 0.38, 500건 칸이 0.64, 최대가 1.0이 되어 중간 단계가 비로소 펼쳐집니다.
확대하면 점이 규칙적인 격자로 늘어섬
거리 수준까지 확대하면 점 배열이 수상하고 도로와 맞지 않는다는 제보가 있었습니다.
제가 칸의 중심을 그리고 있었기 때문입니다. 13미터 칸의 중심을 그리면 거리 수준에서는 격자선이 보이고, 도로가 모든 칸의 중심을 지날 리도 없습니다.
데이터베이스를 다시 만들어 각 칸에 든 사고들의 위경도 합계도 저장하고, 질의할 때 그 칸의 실제 무게중심을 돌려주도록 했습니다. 이제 점이 도로 위에 얹혀 도로망을 따라 분포합니다.
돌아보며
여섯 가지 중 기술적 문제는 네 번째와 다섯 번째뿐이고, 나머지는 "데이터가 깔끔할 것"이라는 전제에서 나왔습니다. 정부 공개 데이터는 사실 품질이 괜찮습니다. 항목도 세밀하고 갱신도 부지런합니다. 다만 행정 용도로 설계된 것이고, 그 용도는 지도를 그리는 것이 아닙니다. 좌표는 나중에 채워 넣은 것이며, 채우는 방식에는 그 나름의 논리가 있고, 그 논리는 통계에서는 무해하지만 지도 위에서는 치명적입니다.
다음에 공개 데이터를 받으면, 그리기 전에 가장 극단적인 값들이 어디서 왔는지부터 보러 갈 생각입니다.