把一百萬件交通事故畫成地圖:六個做錯之後才發現的坑
這個網域上線了第三個工具,一張交通事故熱點地圖。資料是政府公開的,看起來下載下來就能用。實際做完之後,這篇記錄中間六個做錯的地方。
2026-08-20 作者 William Hsu
資料長什麼樣
警政署在政府資料開放平臺上放了逐案的傷亡道路交通事故資料,A1 類是 24 小時內死亡的, A2 類是受傷或超過 24 小時死亡的。我用了 113 年、114 年的全年份,加上 115 年到 8 月的滾動資料。
- 原始列數 2,287,215
- 欄位 51 個,含經緯度、天候、光線、速限、號誌、肇因研判、當事者年齡與保護裝備
- 涵蓋期間 2024 年 1 月到 2026 年 8 月,32 個月
下載下來是 zip,解開三年份是 1.5 GB。我的磁碟不夠,所以整條管線改成直接從 zip 串流讀取, 不落地。
一、一列是一個當事者,不是一件事故
一件事故有幾個當事者就有幾列。一輛車撞一台機車就是兩列,時間、地點、經緯度完全相同, 只有「當事者順位」不同。
228 萬列去重之後是 101 萬件,平均每件 2.26 個當事者。如果直接數列數, 所有數字都會膨脹超過兩倍。
二、全台灣最大的事故熱點在新北市政府門口
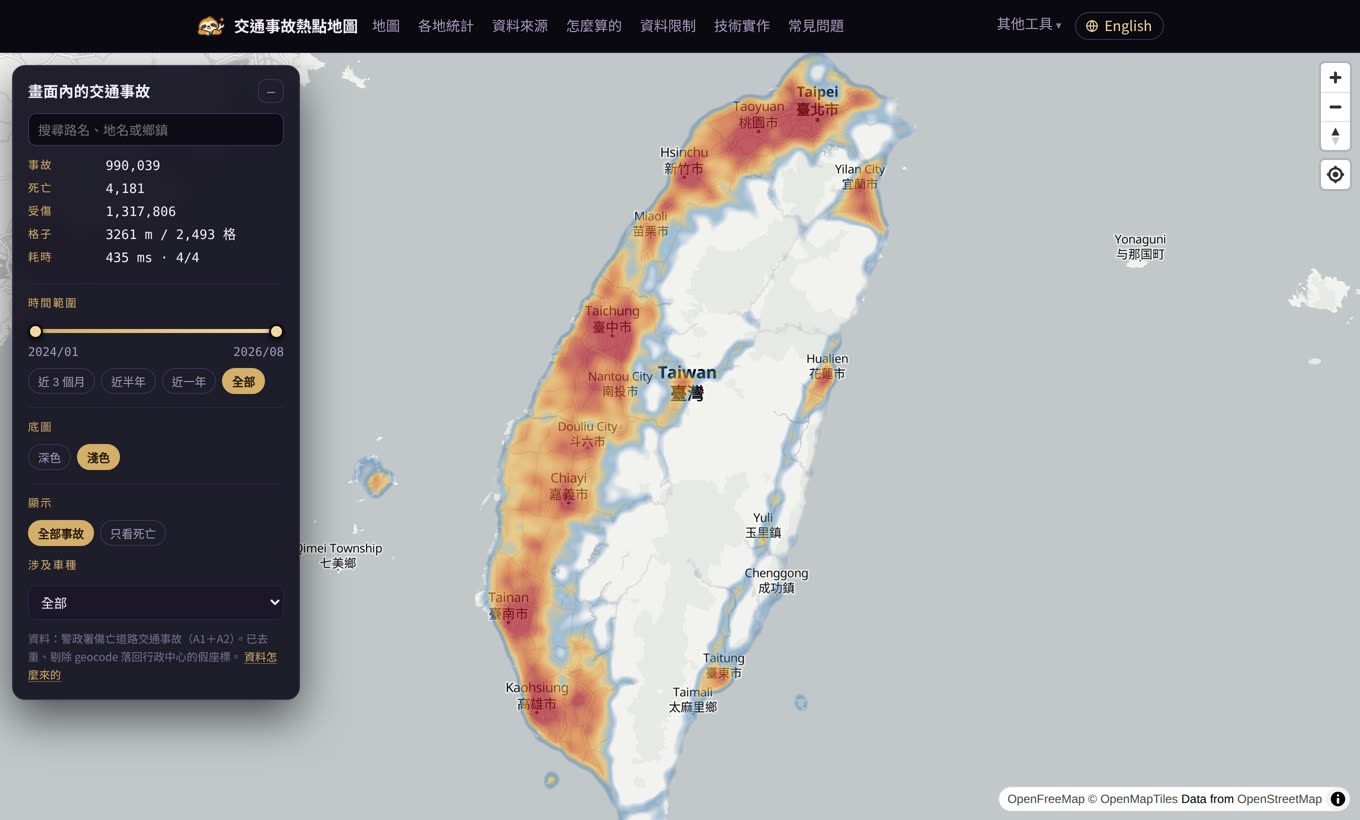
第一次把資料畫出來,最亮的一點在新北市板橋,位置是 121.481, 25.009。 那裡一年堆了兩千多件事故。
那是新北市政府的座標。地理編碼失敗的時候系統會退回一個預設值,那個預設值就是該縣市政府的位置。查了一下那個點上的事故地址,橫跨 20 個行政區,三峽、八里、坪林都有。
抓出來的方法很簡單:同一個座標的事故地址如果橫跨三個以上的行政區,那就是假點。 真實的路口不會同時在三峽和八里。全台抓到 128 個這種點、17,784 件事故,佔 1.76%。
比例不高,但它剛好堆在同一個位置,所以在熱點圖上就是最大的那一團。 不處理的話,整張圖最顯眼的資訊是錯的。
三、這份資料不能拿來排「最危險路口」
這一條跟程式無關,是資料本身的性質。
臺中市的事故件數全國最多,一年 70,765 件。但把全國前 200 個熱點排出來, 新北市佔 121 個,臺中市只有 19 個。
原因是各縣市的地理編碼行為不同。同一個座標被重複使用的比率, 新北市是 1.38,臺北市只有 1.01。臺北市幾乎每一件事故都有獨一無二的座標, 所以永遠聚不出一個「熱點」。
任何用這份資料排出來的最危險路口排行,排的都是各縣市的地理編碼行為,不是危險程度。這個工具因此刻意不做排行榜,只做範圍統計。 在 300 到 500 公尺的範圍裡,幾十公尺的座標誤差會被抹平。
另外有 26.2% 的地址寫成「○○路前0.0公尺」,那是路段的參考點,不是事故發生的那一點。 街道層級的判斷可以參考,路口層級的結論下不了。
四、每移動一下就重抓整個畫面
第一版的 API 吃 bbox:前端把當前的地圖範圍送上來,後端回那個範圍的資料。 能動,但地圖只要平移一個像素,bbox 就是一個新的網址,於是整批重抓, 而且瀏覽器和 CDN 都無法快取。實測一次回應 954 KB。
改成把地圖切成固定的圖磚,網址變成 /api/cells/{z}/{x}/{y}。網址固定就能快取, 平移時只抓新露出來的那幾塊:
- 初次載入 12 塊圖磚,195 KB
- 平移 200 像素 只抓新的 3 塊,約 10 KB
- 再移回來 0 個請求,14 毫秒
五、資料庫放在 bind mount 上,慢 74 倍
本機開發一切正常,部署到正式站之後同一個查詢要 5.5 秒。
正式環境的資料夾是從 Windows 主機 bind mount 進 Docker 容器的。 SQLite 做的是大量隨機小量讀取,那種存取模式在那上面慢得離譜。 同一個查詢的三種情況:
- 開發機本機碟 74 毫秒
- 容器讀 bind mount 5,500 毫秒
- 容器讀本機複本 84 毫秒
解法是啟動時把資料庫循序複製到容器自己的檔案系統再用。循序讀很快, 122 MB 只要幾秒。這個問題在開發機上完全看不出來,只有部署之後才會現形。
六、顏色調錯兩次,一次全紅一次全藍
熱力圖的權重是相對值,怎麼把事故數換算成 0 到 1 的權重決定了整張圖的觀感。
第一次是全紅:我把 API 從 bbox 改成圖磚的時候,漏掉了權重欄位。 前端讀不到就當成沒設定,於是每一格的權重都是滿的,不管那一格是 1 件還是 300 件。
第二次是全藍:我改用第 97 百分位當滿分。問題是這份資料的分布極度偏斜。全台視野下中位數只有 38 件,最高的一格 15,601 件,差 400 倍。 用第 97 百分位當分母,97% 的格子權重都趨近 0。
最後改成對最大值取對數。中位數的格子拿到 0.38、五百件的 0.64、最高的 1.0, 中間層次才展得開。
放大之後點排成規則的方格
使用者回報放大到街道層級時,點的排列很可疑,而且對不上馬路。
因為我畫的是格子的中心。13 公尺的格子畫中心,在街道層級就會看到格線, 而馬路當然不會剛好通過每個格子的中心。
修法是重建資料庫,把每一格裡事故的經緯度總和也存起來,查詢時回傳那一格的實際重心。 現在點會落在馬路上,沿著路網分布。
回頭看
這六個坑裡只有第四和第五個是技術問題,其他都是「以為資料乾淨」造成的。 政府開放資料的品質其實不錯,欄位很細、更新也勤,但它是為了行政用途設計的,用途不是畫地圖。座標是後來補上的,補的方式有它自己的邏輯, 而那個邏輯在統計上無害、在地圖上致命。
下次拿到公開資料,我會先去看最極端的那幾個值是怎麼來的,再開始畫圖。