Un video de 42 segundos sin abrir un editor: filmar un mapa en movimiento fotograma a fotograma
Hice un video de 42 segundos para Mascotas perdidas sin abrir nunca un editor ni grabar la pantalla: cada fotograma está calculado. Aquí está el método, incluidas las seis versiones que salieron mal.
2026-08-31 作者 William Hsu
Primero, el resultado
La estructura es sencilla: la foto de un perro → la foto se encoge hasta ser una chincheta en el mapa → el mapa se aleja y van apareciendo casos → todo Taiwán → las chinchetas salen volando y se ordenan formando la portada del sitio.
El perro del principio está generado, y conviene decirlo antes que nada
El teckel de la apertura lo generó un modelo de video local (MiniMax H3, en mi propia tarjeta gráfica), y su «caso de mascota perdida» solo existe dentro del navegador con el que se filmó: un script lo insertó en el mapa para la toma, y el sitio real no tiene ese registro. La razón es directa: hay gente usando ese sitio para buscar animales de verdad, y meter un caso falso sería usar su atención como atrezo. La imagen es idéntica y la base de datos se queda limpia.
Todas las demás chinchetas del video son avisos reales del mapa, y «más de ocho mil» es la cifra de los datos abiertos oficiales.
El mapa no se puede grabar de pantalla
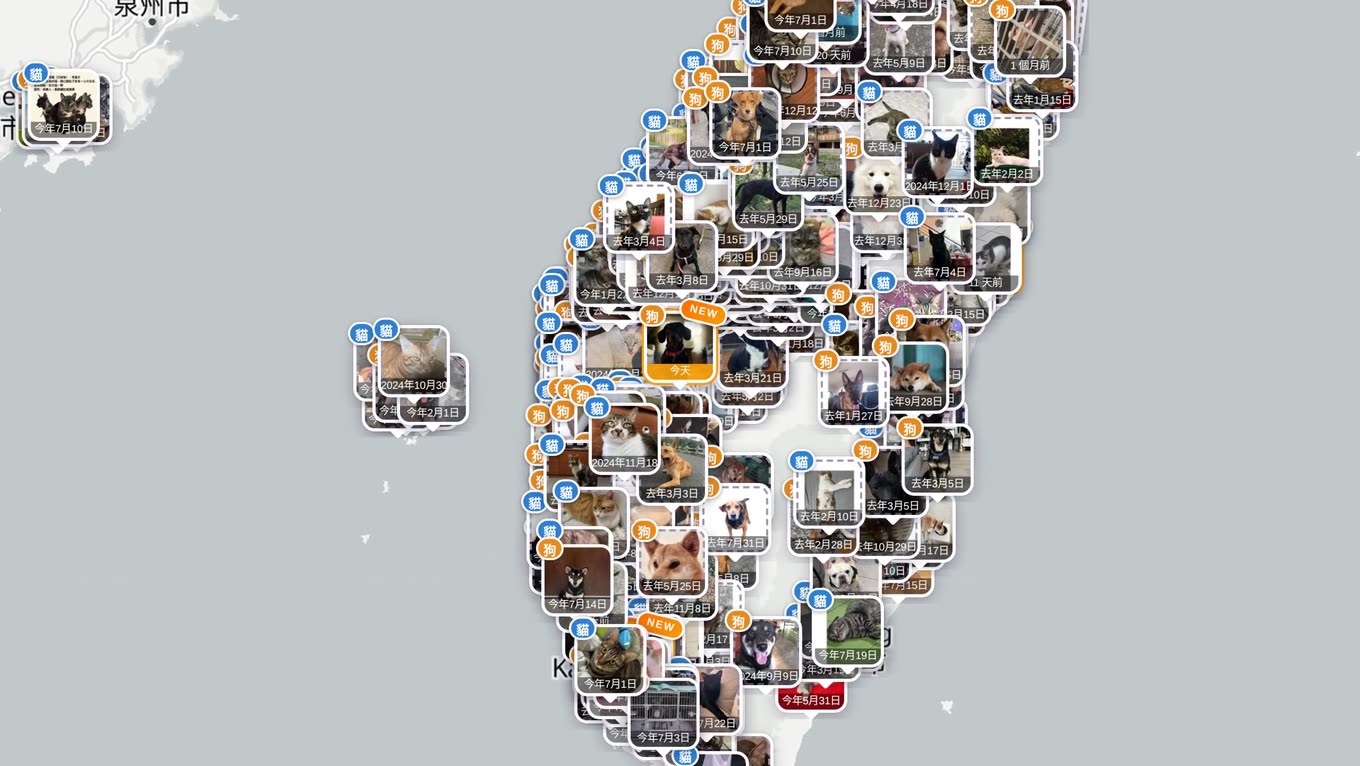
Lo evidente sería animar la cámara en el navegador y grabar la pantalla. Bastó una prueba para descartarlo: a máxima densidad hay más de cuatrocientas chinchetas con foto en pantalla, el zoom continuo pierde muchísimos fotogramas y una retirada de veinte segundos pasa casi de golpe en la grabación.
En su lugar, fotos fijas y montaje: capturar una imagen base en cada uno de seis niveles de zoom (separados 1,68 niveles, unas 3,2× cada salto) y calcular las transiciones con la proyección Web Mercator. Sabiendo el centro y el nivel de zoom de cada toma se puede deducir qué parte de la imagen siguiente ocupaba la vista anterior, recortar y escalar entre ambas de forma exponencial, y eso da una retirada a velocidad constante. Seiscientos fotogramas, escritos uno a uno.
Las chinchetas hay que tratarlas aparte del mapa base
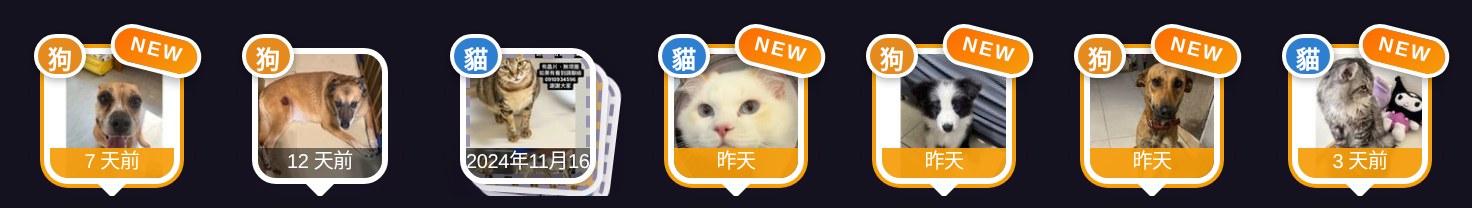
La primera versión ampliaba la captura entera, y el fallo se vio enseguida: las chinchetas se dibujan a 68 píxeles fijos en pantalla y no crecen ni menguan con el mapa. Al ampliar toda la captura, las chinchetas se hinchaban y encogían, con un latido en cada tramo.
La solución es separarlas: el mapa base se escala como siempre, y las chinchetas se capturan aparte, se convierte su latitud y longitud en una posición de pantalla y se pegan de vuelta a tamaño fijo, fotograma a fotograma. Así los casos van «brotando» uno a uno mientras el mapa se aleja, y las chinchetas nunca cambian de tamaño.
La forma de capturarlas se rehízo tres veces, y todos los problemas los detectó un ojo humano:
- Recortar una chincheta de la captura completa: en zonas densas venían también las vecinas, y un recorte tenía tres perros
- Mostrar cada chincheta sola y recortarla restando una toma sin chinchetas: la sombra es semitransparente, así que tras la resta el anillo de sombra se llevaba al recorte los nombres de calle que había debajo
- Al final: ocultar el mapa entero durante la captura y poner el fondo de la página transparente, lo que da un PNG con alfa real, y entonces una sombra es una sombra
La narración y la música también están sintetizadas
La narración es una voz masculina taiwanesa de Microsoft (edge-tts) ralentizada un 8% y colocada frase a frase contra la línea de tiempo de la imagen. Pensaba buscar música libre y acabé sintetizándola con código: un arpegio de piano de fieltro en el que cada nota tiene su envolvente de ataque y caída. La primera versión usaba ondas senoidales puras y sonaba a tonos de teclado telefónico; la envolvente es lo que hace que suene a instrumento.
Hicieron falta siete versiones
Siete montajes en total, y todos los problemas los vio una persona, no los reportó el código: chinchetas pegadas a sus vecinas, sombras arrastrando el mapa base, marcadores de avistamiento colados entre los recortes, la salida en SD y una frase final de narración reescrita tres veces. La IA puede rodar el video, pero «esto está mal» siempre lo dice un humano. Probablemente sea el reparto de tareas más honesto de todo el proceso.
La herramienta está en lazetool.com/lost-pet (en chino).