Um vídeo de 42 segundos sem abrir editor: filmar um mapa em movimento quadro a quadro
Fiz um vídeo de 42 segundos para o Pets perdidos sem abrir editor nenhum e sem gravar a tela: cada quadro foi calculado. Aqui está o método, incluindo as seis versões que saíram erradas.
2026-08-31 作者 William Hsu
Primeiro, o resultado
A estrutura é simples: a foto de um cachorro → a foto encolhe até virar um alfinete no mapa → o mapa se afasta e os casos vão surgindo → Taiwan inteira → os alfinetes voam e se organizam formando a capa do site.
O cachorro do começo é gerado, e isso precisa ser dito antes de tudo
O dachshund da abertura foi gerado por um modelo de vídeo local (MiniMax H3, na minha própria placa de vídeo), e o “caso de pet perdido” dele existe só dentro do navegador usado para filmar: um script o inseriu no mapa para a tomada, e o site real não tem esse registro. O motivo é direto: tem gente usando aquele site para procurar bichos de verdade, e inserir um caso falso ali seria usar a atenção dessas pessoas como adereço. A imagem fica idêntica e o banco de dados continua limpo.
Todos os outros alfinetes do vídeo são avisos reais do mapa, e “mais de oito mil” é o número dos dados abertos oficiais.
O mapa não dá para gravar da tela
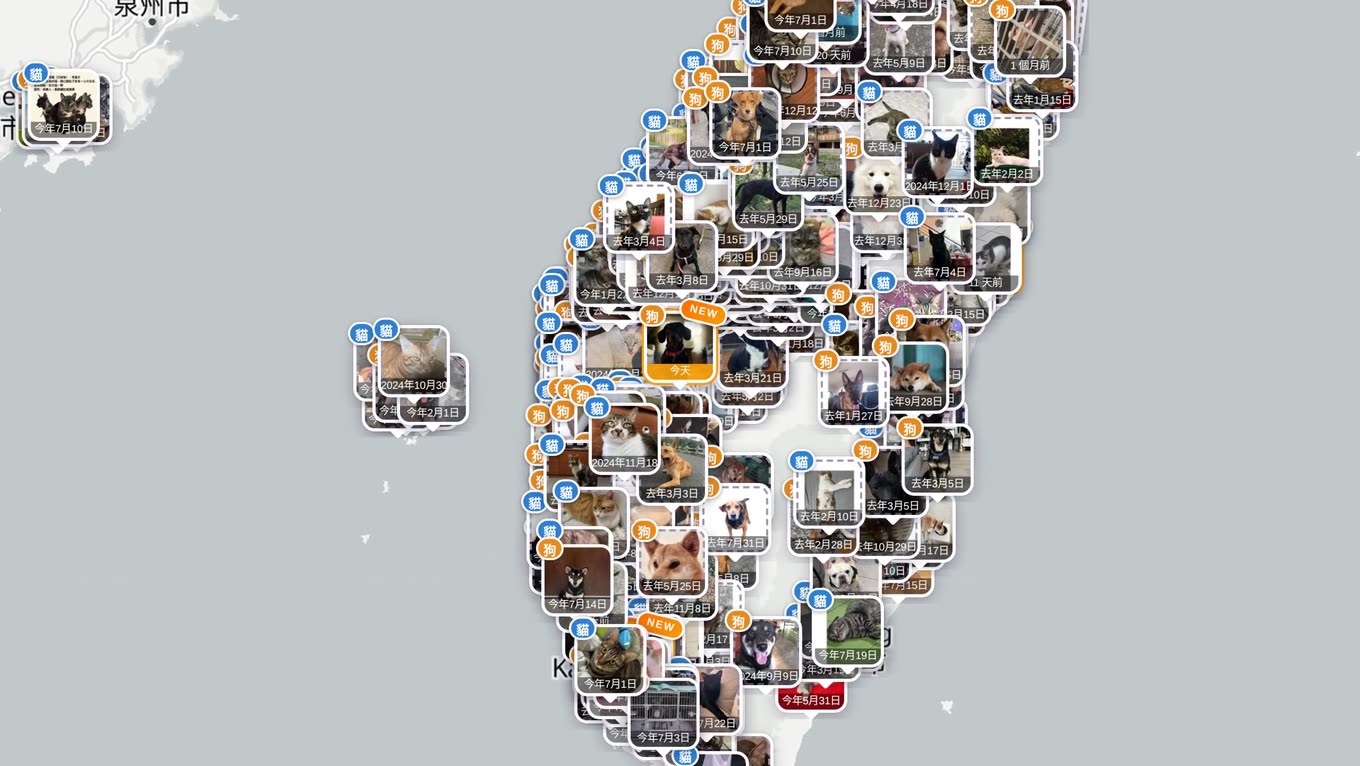
O caminho óbvio seria animar a câmera no navegador e gravar a tela. Um teste bastou para abandonar: na densidade máxima há mais de quatrocentos alfinetes com foto na tela, o zoom contínuo perde quadros feio e um afastamento de vinte segundos praticamente pula na gravação.
Em vez disso, fotos paradas e montagem: capturar uma imagem base em cada um dos seis níveis de zoom (separados por 1,68 nível, cerca de 3,2× por salto) e calcular as transições pela projeção Web Mercator. Sabendo o centro e o nível de zoom de cada tomada, dá para deduzir que parte da imagem seguinte a vista anterior ocupava, recortar e escalar entre as duas de forma exponencial, e isso dá um afastamento em velocidade constante. Seiscentos quadros, escritos um a um.
Os alfinetes têm de ser tratados à parte do mapa base
A primeira versão simplesmente ampliava a captura inteira, e o problema apareceu na hora: os alfinetes são desenhados com 68 pixels fixos na tela e não crescem nem encolhem com o mapa. Ampliando a captura toda, os alfinetes inchavam e encolhiam, pulsando a cada trecho.
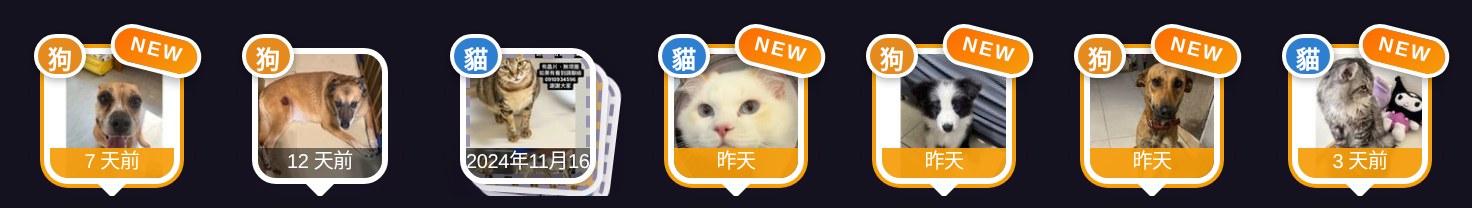
A solução é separar: o mapa base é escalado normalmente, e os alfinetes são capturados à parte, com a latitude e a longitude convertidas em posição de tela e colados de volta em tamanho fixo, quadro a quadro. Assim os casos vão “brotando” um a um enquanto o mapa se afasta, e os alfinetes nunca mudam de tamanho.
O jeito de capturá-los foi refeito três vezes, e todos os problemas foram vistos por olho humano:
- Recortar um alfinete da captura completa: em áreas densas os vizinhos vinham junto, e um recorte tinha três cachorros
- Mostrar cada alfinete sozinho e recortá-lo subtraindo uma tomada sem alfinetes: a sombra é semitransparente, então depois da subtração o anel de sombra levava junto os nomes de rua que estavam embaixo
- No fim: esconder o mapa inteiro durante a captura e deixar o fundo da página transparente, o que gera um PNG com canal alfa real — assim, a sombra continua sendo apenas sombra
A narração e a música também são sintetizadas
A narração é uma voz masculina taiwanesa da Microsoft (edge-tts) desacelerada em 8% e encaixada frase a frase na linha do tempo da imagem. Eu pretendia achar música livre e acabei sintetizando no código: um arpejo de piano de feltro em que cada nota tem envelope de ataque e decaimento. A primeira versão usava ondas senoidais puras e soava como tom de teclado de telefone; o envelope é o que faz aquilo soar como instrumento.
Foram sete versões
Sete montagens no total, e todos os problemas foram vistos por uma pessoa, não reportados pelo código: alfinetes grudados nos vizinhos, sombras arrastando o mapa base, marcadores de avistamento misturados aos recortes, a saída só em SD e uma frase final de narração reescrita três vezes. A IA consegue gerar o vídeo, mas “isso aqui está errado” sempre vem de um humano. Provavelmente é a divisão de trabalho mais honesta de tudo isso.
A ferramenta está em lazetool.com/lost-pet (em chinês).